本书依据「大模型加速优化技术全景图」逐主题展开。全景图把 LLM 的加速优化技术划成八大板块——训练加速、模型压缩、推理加速、架构优化、长上下文加速、系统与硬件、框架与工具、效果评估。本书就按这八个板块,把每一条技术从"是什么、为什么、怎么做、有什么坑"讲清楚。先建立全景认知,再逐个深入。
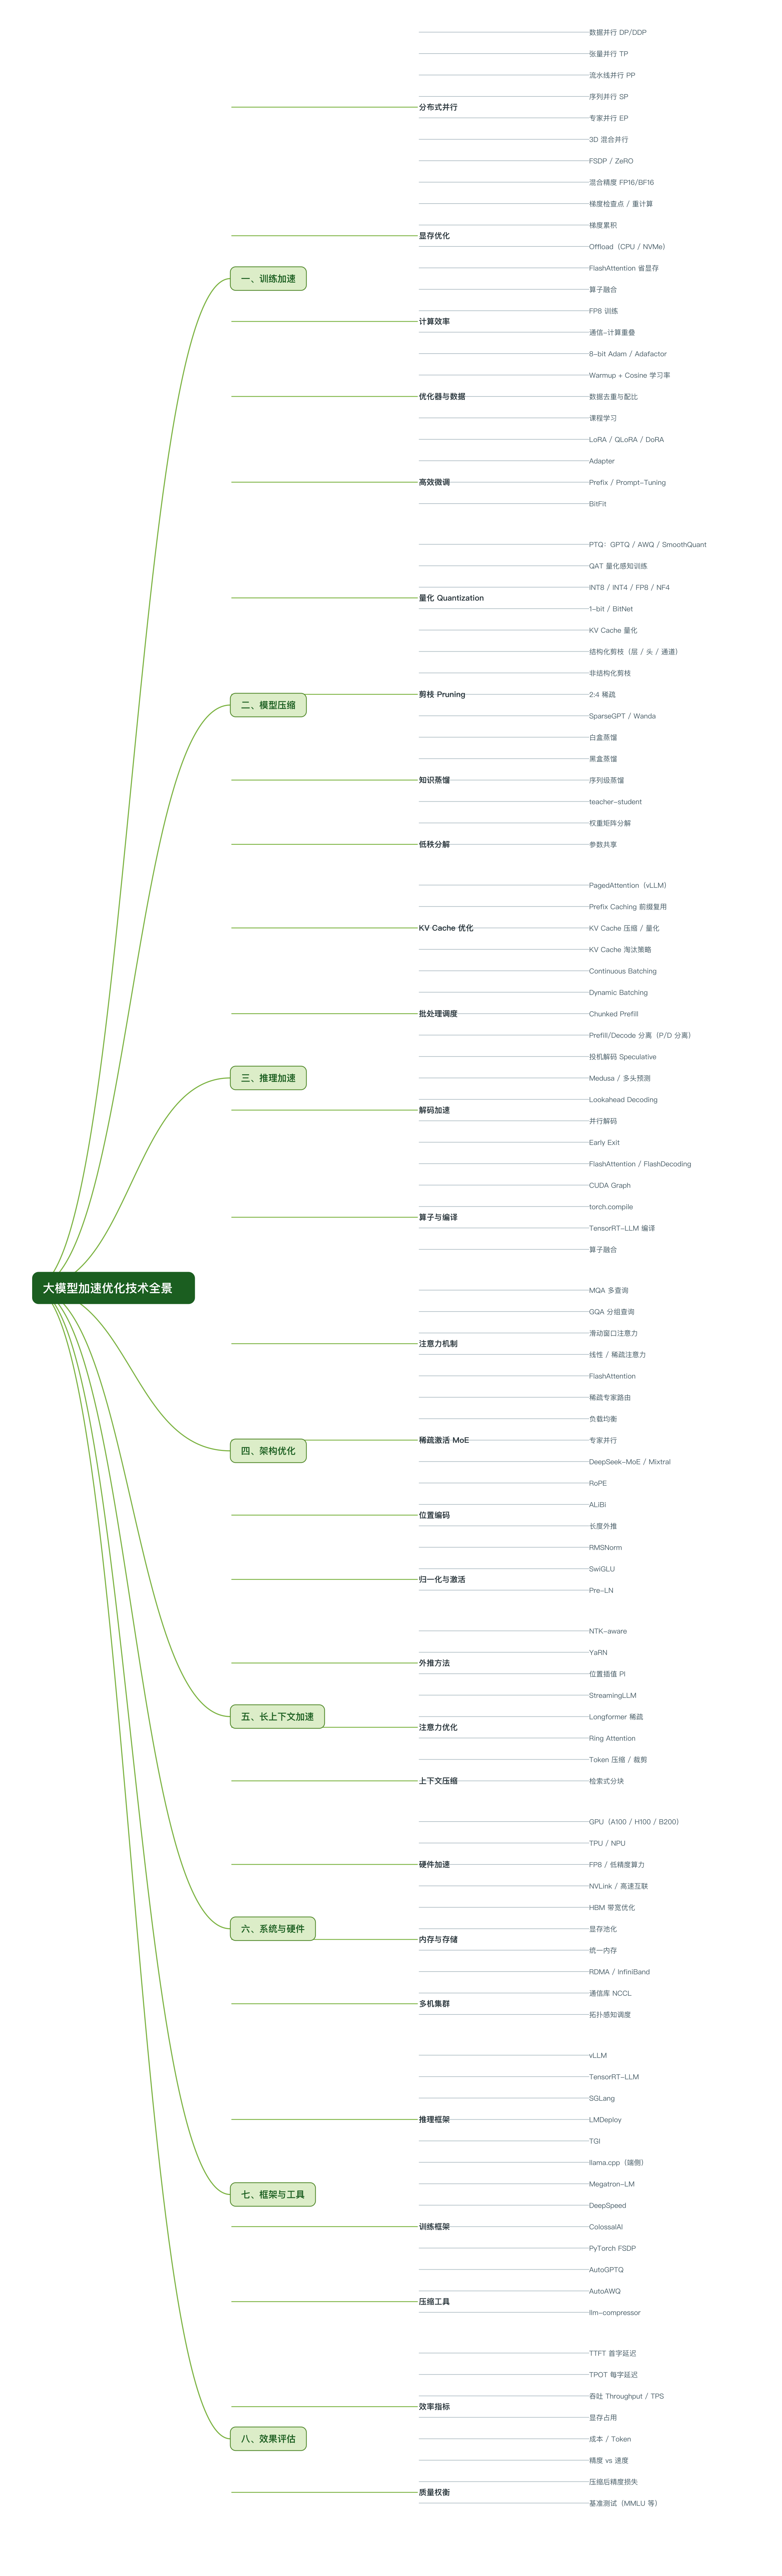
全景导读
大模型的两个阶段——训练和推理——成本都很高,都要大量算力。落地时还要解决响应 速度(TTFT 首字延迟、TPOT 每字延迟)这类体验指标。加速优化就是把"同样的模型,用更少 的算力、更短的时间、更低的成本跑出来"这件事拆开成八个可操作的维度:
- 训练加速:让训练本身更快、更省显存(并行、混合精度、高效微调)。
- 模型压缩:让模型变小、变轻,推理时更快(量化、剪枝、蒸馏、低秩分解)。
- 推理加速:推理引擎层面的调度、缓存、编译优化(KV Cache、批处理、投机解码)。
- 架构优化:改模型结构,从源头降低计算量(注意力变体、MoE、位置编码)。
- 长上下文加速:突破训练长度、低成本跑超长上下文(外推、稀疏、压缩)。
- 系统与硬件:底层算力、内存、多机互联(GPU/TPU、HBM、RDMA)。
- 框架与工具:把上面所有技术工程化、开箱即用的框架和工具。
- 效果评估:用指标说话——速度、显存、成本、精度损失如何权衡。
下面逐章展开。
一、训练加速
训练是 LLM 生命周期里最贵的一环:几十亿到万亿参数,动辄千卡、跑几周。加速优化围绕 三个瓶颈展开——并行不够(单卡装不下/跑不动)、显存不够(激活、梯度、优化器 状态撑爆显存)、算得慢(算子效率低、通信占空高)。五大子类对症下药。
1.1 分布式并行
单张 GPU 的显存和算力都装不下一个大模型,必须把计算切到多卡上。并行方式决定了"怎么切"。
- 数据并行 DP / DDP:每张卡拿完整模型的一份副本,喂不同的数据批次,算完梯度 做 all-reduce 求平均再各自更新。最简单,但每卡都要装下完整模型+优化器状态,大模型 下显存爆炸。DDP(DistributedDataParallel)用 Ring-AllReduce 让通信和反向传播重叠, 比朴素 DP 快。
- 张量并行 TP:把单层内的权重矩阵切成列/行,分到多卡,一层就要跨卡做 all-gather / reduce-scatter。适合卡间带宽极高(NVLink)的单机内,把大模型压进一台机器。
- 流水线并行 PP:把模型按层切成几段,每段放不同卡,像流水线一样不同批次同时在 不同段上跑。代价是"气泡"(流水线填满/排空时空闲),要靠 micro-batch 和 interleaving 调度去消气泡。
- 序列并行 SP:把序列维度也切到多卡,配合 TP 用,进一步摊薄 LayerNorm、Dropout 这类按序列算的激活显存。
- 专家并行 EP:MoE 模型专用,把不同的专家路由到不同卡上,只激活当前 token 需要的 那部分专家。和 TP/PP 一起构成多维并行。
- 3D 混合并行:实际训大模型几乎都用"TP(单机内)× PP(机间)× DP(副本间)"三维 混合,再加 SP/EP,把模型、序列、数据、专家四个维度都切开,是训千亿模型的标配。
- FSDP / ZeRO:不切模型结构,而是把优化器状态、梯度、参数三者都按数据并行维度 分片存,每卡只持有 1/N,用时再 all-gather。ZeRO 1/2/3 分别对应只分片优化器状态、+ 梯度、+ 参数;FSDP 是 PyTorch 原生实现。显存收益巨大,是训大模型的默认选择。
怎么选:小模型(<几十 B)用 DP + ZeRO/FSDP 就够;上百 B 到千亿才需要上 TP/PP 的 3D 并行,而且 TP 一定放在 NVLink 互联的单机内。
1.2 显存优化
显存是训练的硬天花板。模型参数、梯度、优化器状态、激活值四块都要占显存,优化目标就是 把每一块都压小。
- 混合精度 FP16 / BF16:前向用半精度算(省显存、GPU 算力更高),但权重和梯度累加 用 FP32 主副本保精度。BF16 动态范围比 FP16 大、不易溢出,A100/H100 上是首选。
- 梯度检查点 / 重计算:反向传播需要前向的激活值,全存会把显存撑爆。检查点只存少数 层的激活,反向时把那几层重新前向算一遍——用约 30% 额外计算换下几十倍激活显存。
- 梯度累积:显存装不下大批量时,把一个大 batch 拆成多个小 step 前向+反向,梯度累加 后一起更新,等效大批量但不多吃显存。
- Offload(CPU / NVMe):把优化器状态或参数暂时挪到内存甚至磁盘,需要时再搬回。 ZeRO-Offload / ZeRO-Infinity 用这个把超大模型压进有限显存,代价是 PCIe/NVMe 带宽 拖慢训练。
- FlashAttention 省显存:把注意力的中间矩阵(softmax 的 N×N 项)不落显存,直接在 SRAM 里算完写回,激活显存从 O(N²) 降到 O(N),同时更快。训练推理都受益。
1.3 计算效率
让"有效计算"占比更高,把"无效开销"压下去。
- 算子融合:把多个小算子(如 LayerNorm + 乘 + 加)融成一个 kernel,减少显存读写和 kernel 启动开销。Transformer 里 attention、softmax 都和后面的 mul/add 融合,是各家 训练框架的标准优化。
- FP8 训练:在 H100/B200 等支持 FP8 算力的卡上,用 8-bit 浮点做前向/反向,比 FP16 快、比 BF16 更省带宽。需要 scale 因子保数值稳定,是新一代 GPU 的主力训练精度。
- 通信-计算重叠:把 all-reduce / all-gather 这类通信和计算放在不同 CUDA stream 上并行执行,让通信"藏"在计算里,而不是串行等待。TP 的 reduce-scatter 和反向计算重叠 是关键。
1.4 优化器与数据
- 8-bit Adam / Adafactor:把 Adam 的一阶/二阶矩用 int8 存,优化器状态显存降 4 倍; Adafactor 进一步把二阶矩降秩分解,再省一倍。训超大模型时优化器状态常是显存大头。
- Warmup + Cosine 学习率:开头线性升温避免早期不稳,之后按余弦衰减到极低。简单 但几乎总是必要的训练技巧。
- 数据去重与配比:训练前对语料去重(MinHash 等)、按领域配比,去掉重复和脏数据能 显著提质,也省训练步数。
- 课程学习:先易后难,或按难度/领域排数据顺序,让模型循序渐进,收敛更稳。
1.5 高效微调
全量微调动辄千卡,多数下游任务只需在冻结大模型上"轻量加参"。
- LoRA / QLoRA / DoRA:冻结原权重,在注意力层旁挂低秩矩阵 A·B(rank 远小于原维度), 只训这两个小矩阵。QLoRA 把底座量化到 4-bit 再训 LoRA,消费级显卡就能微调几十 B 模型。 DoRA 把 LoRA 拆成方向+幅度两个低秩分量,效果通常更好。
- Adapter:在每层间插入小型 MLP 模块,冻结主模型只训这些模块。比 LoRA 参数多, 但也是免全量微调的路线。
- Prefix / Prompt-Tuning:在输入前挂一段可学习向量(Prefix 注入 KV,Prompt-Tuning 只改 embedding),只训这段向量,适合快速适配且不想动权重的场景。
- BitFit:只调位置编码或 Bias 这类极小参数,微调成本极低,适合轻量适配。
二、模型压缩
训练完的模型要上线推理,往往太大太慢。压缩的目标是"在不明显掉点的前提下,把模型变小、 变快"。四条主线:量化、剪枝、蒸馏、低秩分解。
2.1 量化 Quantization
把权重(乃至激活、KV Cache)从 FP16 降到更低比特,是最主流的压缩手段。
- PTQ:GPTQ / AWQ / SmoothQuant:训练后量化,不重训。GPTQ 用观测激活逐列量化权重, 误差补偿;AWQ 观察到少数"显著通道"扛住精度,保这几路不量化、其余压到 4-bit; SmoothQuant 把激活的离群值"迁移"到权重上,让激活也能量化。
- QAT 量化感知训练:训练时就模拟低精度(伪量化),让模型适应量化误差,精度最好但 要重训。
- INT8 / INT4 / FP8 / NF4:常见量化位宽。INT8 几乎无损;INT4/FP8 是 7B~70B 模型 单机部署的主力;NF4(4-bit NormalFloat)是 QLoRA 用的非均匀 4-bit,专为正态分布 权重设计。
- 1-bit / BitNet:把权重压到 1-bit({-1, +1}),推理退化成加减法,算力极低。代价是 量化误差大,需要专门训练或特殊结构。
- KV Cache 量化:推理时 KV Cache 占显存大头,把它量化到 INT8/INT4,直接省显存、 提吞吐,几乎无损。
2.2 剪枝 Pruning
去掉不重要的连接或结构,稀疏化模型。
- 结构化剪枝(层 / 头 / 通道):整层、整注意力头、整通道删掉,直接减少 FLOPs 和 显存,剪完模型真的变小。但需要校准数据选"哪些不重要"。
- 非结构化剪枝:逐个权重置零,稀疏率能很高,但需要专用稀疏硬件(如 2:4)才能兑现 加速,普通 GPU 上加速有限。
- 2:4 稀疏:每 4 个权重强制留 2 个非零,Tensor Core 原生支持 2:4 结构化稀疏,2 倍 算力,是 GPU 硬件层的剪枝加速。
- SparseGPT / Wanda:免训练的一刀剪。SparseGPT 逐列观测误差一次性剪稀疏;Wanda 只用权重幅值(不跑激活)判断重要性,快且效果好。
2.3 知识蒸馏
用一个强教师模型把知识"喂"给小模型,让小模型逼近大模型效果。
- 白盒蒸馏:能访问教师 logits 和中间表示,让学生对齐软标签/特征,效果最好。
- 黑盒蒸馏:只有教师的输出文本(如 API),用教师的回答当训练数据训学生。
- 序列级蒸馏:在整段序列/回复层面蒸馏,而非逐 token 对齐。
- teacher-student:通用框架——教师大、学生小,学生模仿教师的行为分布,是 LLM 蒸馏的标准范式(如用 70B 蒸 7B)。
2.4 低秩分解
- 权重矩阵分解:把大权重矩阵分解成两个小矩阵的乘积(A·B),降低参数量和计算量。 和 LoRA 同源思路,但用于推理侧压缩。
- 参数共享:让多个模块复用同一份参数(如跨层共享权重、共享 embedding),直接砍 冗余参数。
三、推理加速
推理引擎的优化集中在"怎么把 GPU 算力榨干、把延迟压下去"。四大子类:KV Cache、批处理 调度、解码加速、算子与编译。
3.1 KV Cache 优化
LLM 自回归生成时,每步都要用到前面所有 token 的 Key/Value,KV Cache 就是把这些缓存住, 避免重复算注意力。它占显存最大,优化它就是推理提速的主战场。
- PagedAttention(vLLM):把 KV Cache 切成固定大小的"页",像操作系统分页内存一样 管理,页可以非连续分配,显存碎片归零,利用率从 ~50% 提到 90%+。vLLM 的招牌。
- Prefix Caching 前缀复用:多个请求共享同一段前缀(如 system prompt、few-shot), 这段的 KV 算一次、所有请求复用,省大量 prefill 计算。
- KV Cache 压缩 / 量化:把 KV 压到 INT8/INT4,显存减半甚至更多,配合 PagedAttention 能塞下更长上下文。
- KV Cache 淘汰策略:长序列下 KV 放不下时,按重要性(如 attention 分数)淘汰不重要的 token 的 KV,是"Streaming 记忆"思路,牺牲极小换取无限长上下文。
3.2 批处理调度
GPU 要靠批量才能喂饱,调度策略决定利用率。
- Continuous Batching:不等一整个 batch 都跑完,而是哪个请求生成了下一个 token 就 立刻把新请求插进来,持续拼批,吞吐拉满。vLLM/TGI 的核心。
- Dynamic Batching:动态调整每步的 batch 大小,根据队列负载自适应,避免空转。
- Chunked Prefill:把长 prefill 切成小块,和 decode 交错执行,避免一个长 prefill 把整批的 decode 全部卡住,降低 TPOT 抖动。
- Prefill/Decode 分离(P/D 分离):prefill(计算密集)和 decode(访存密集)用不同的 卡/实例跑,各调各的优化,互不干扰,是大规模推理集群的趋势。
3.3 解码加速
- 投机解码 Speculative:用一个小模型先"投机"生成一段候选 token,大模型一次性验证, 接受匹配的部分。小模型快、大模型验证是批量的,端到端延迟大幅下降,输出分布不变。
- Medusa / 多头预测:在模型末尾加多个解码头,一次并行预测后续多个 token,接受率 高时加速明显。
- Lookahead Decoding:用一个小的 lookahead 模型并行探索多条路径,主模型验证接受。
- 并行解码:投机解码的泛化——多条候选路径并行生成、批量验证。
- Early Exit:简单 token 提前结束网络(浅层就出结果),复杂 token 才走全网络, 平均计算量下降。
3.4 算子与编译
- FlashAttention / FlashDecoding:FlashAttention 把注意力在 SRAM 里算完不落显存、 O(N) 激活;FlashDecoding 针对解码阶段(单 token 对长 KV)再做分块并行,解码更快。
- CUDA Graph:把推理的整段 kernel 启动序列录成一张图,一次性提交,省掉每步 CPU 发起 kernel 的开销。decode 这种小 kernel 密集场景收益巨大。
- torch.compile:PyTorch 2 的图编译器,自动做算子融合、kernel 优化,一行代码加速。
- TensorRT-LLM 编译:NVIDIA 的推理引擎,图编译 + 算子融合 + 量化 + 调度一体化, 显式控制延迟和吞吐的权衡。
- 算子融合:同训练侧,把相邻算子合并减少访存和启动开销。
四、架构优化
不改推理引擎,而是改模型结构本身,从源头降低计算量或显存。四大子类。
4.1 注意力机制
标准 Transformer 注意力是 O(N²),KV Cache 也随头数线性增长。各种变体在保效果下砍这两项。
- MQA 多查询:所有注意力头共享同一组 Key/Value 投影,KV Cache 降到 1/头数,推理显存 和带宽大省,代价略掉点。
- GQA 分组查询:MQA 的折中——把头分组,每组共享一组 KV,既省显存又保住精度, 是现在主流模型(Llama 3 等)的默认。
- 滑动窗口注意力:每个 token 只看最近 W 个 token 的 KV,KV Cache 变成 O(W),固定 显存、无限长输入,牺牲长距离依赖(Mistral 用的就是这套)。
- 线性 / 稀疏注意力:用线性注意力把 O(N²) 降 O(N),或用稀疏模式只算局部+少量全局, 适合超长上下文。
- FlashAttention:不改结构、只改计算方式的"注意力加速算子",前面多处已提,这里归到 注意力维度。
4.2 稀疏激活 MoE
- 稀疏专家路由:把 FFN 层换成多个"专家",每个 token 只路由到 top-k 个专家激活, 总参数量大但激活参数量小,训练快、推理省。
- 负载均衡:防止所有 token 都涌向少数热门专家(负载不均),用辅助损失均衡各专家 使用率。
- 专家并行:把不同专家放不同卡,推理时只取需要的专家,和 EP 并行对应。
- DeepSeek-MoE / Mixtral:MoE 的代表实现——DeepSeek 用细粒度专家+共享专家, Mixtral 是 8 专家选 2 的经典架构。
4.3 位置编码
- RoPE:旋转位置编码,把相对位置编码进 query/key 的旋转角,是当前主流,外推性好, 是长上下文扩展的基础。
- ALiBi:给注意力加随距离线性增长的偏置,简单且外推稳健。
- 长度外推:让模型在超出训练长度时仍能工作,常靠 RoPE 的缩放(见第五章)。
4.4 归一化与激活
- RMSNorm:只用均方根做缩放,去掉 LayerNorm 的减均值,更快,主流模型默认。
- SwiGLU:GLU 变体激活函数,配合门控线性单元,比 ReLU 效果好、被大量模型采用。
- Pre-LN:LayerNorm 放在残差连接之前,训练更稳、不易梯度爆炸,是现代 Transformer 的标准放置方式。
五、长上下文加速
模型训练时上下文有限(如 4k/8k/32k),推理却要跑几万甚至百万 token。核心矛盾是 O(N²) 的注意力算力和显存。三大方向:外推、注意力优化、上下文压缩。
5.1 外推方法
让模型在超出训练长度时不崩。
- NTK-aware:按 NTK 插值思路缩放 RoPE 的频率,平衡"记忆"和"外推",比朴素缩放好。
- YaRN:NTK 的改进版,分段处理不同频率,长上下文扩展效果更稳,被许多开源模型采用。
- 位置插值 PI:直接对位置编码做插值压缩,把更长序列塞进模型的原始位置范围。
5.2 注意力优化
长序列下注意力本身太贵,从结构上降复杂度。
- StreamingLLM:注意力"流式窗口"——只保留最近的 N 个 token 加几个起始 token(attention sink),KV 固定大小,可无限流式生成不崩。
- Longformer 稀疏:局部窗口 + 少量全局 token 的稀疏注意力,把 O(N²) 降到 O(N)。
- Ring Attention:把序列环状切到多卡,KV 在卡间环形传递,每卡只持有一部分,支持 超长序列分布式推理。
5.3 上下文压缩
直接减少要送入模型的 token 数。
- Token 压缩 / 裁剪:把长上下文压缩成更短的表示(摘要、向量),或按重要性裁剪掉 不重要的 token。
- 检索式分块:把超长文档切成块、嵌入到向量库,推理时只检索最相关的块拼进上下文, 即 RAG 思路,用检索换无限上下文。
六、系统与硬件
前面都是"软件层"优化,这一章讲底下的算力和硬件如何支撑加速。
6.1 硬件加速
- GPU(A100 / H100 / B200):主力训练/推理卡。A100 有 TF32/BF16 张量核,H100 加 FP8 和更快 HBM3,B200 再上 FP4/更宽互联。代际之间算力、精度支持、互联带宽都在涨。
- TPU / NPU:Google TPU 走自研 ASIC 路线,大集群下性价比高;各类 NPU(含手机/端侧) 针对特定模型做低精度加速。
- FP8 / 低精度算力:H100/B200 原生 FP8 张量核,训练推理都比 FP16 快、带宽省,是 新一代硬件的主力精度。
- NVLink / 高速互联:卡间 NVLink 提供 TB 级带宽,TP 这类频繁跨卡通信的并行必须靠它; 机间靠 InfiniBand/RoCE。互联带宽常是比算力更先到的瓶颈。
6.2 内存与存储
- HBM 带宽优化:推理 decode 是访存密集,HBM 带宽直接决定 TPOT。优化 KV Cache 布局、 量化、避免重复访存,都是在抠 HBM 带宽。
- 显存池化:把多卡的显存池化统一管理(如 PagedAttention 的页池),减少碎片。
- 统一内存:CPU/GPU 共享地址空间,模型可以部分放主机内存、按需换入,是端侧/大模型 落地的常用手段。
6.3 多机集群
- RDMA / InfiniBand:机间高速互联,绕开 CPU 直接搬显存,All-Reduce 这类大通信的 关键,决定多机训练的通信效率。
- 通信库 NCCL:NVIDIA 的集合通信库,把 AllReduce/AllGather 等做高效实现,和 NVLink/ RDMA 对接,是训练框架的通信底座。
- 拓扑感知调度:按网络拓扑(机内/机间、交换机层次)安排并行组,让通信尽量走高速 链路,避免跨交换机慢路径。
七、框架与工具
前面所有技术最终要靠框架/工具落地。三大类。
7.1 推理框架
- vLLM:PagedAttention + Continuous Batching 的代表,吞吐高、易用,是开源推理第一 梯队。
- TensorRT-LLM:NVIDIA 官方引擎,图编译+量化+调度,性能天花板高,配置更重。
- SGLang:RadixAttention(前缀树缓存)+ 高效调度,多轮/复杂 prompt 场景强。
- LMDeploy:国产推理引擎,TurboMind 内核,支持多种量化和批处理。
- TGI:Hugging Face 的推理网关,Continuous Batching + 量化,偏生产部署。
- llama.cpp(端侧):CPU/端侧推理主力,GGUF 量化格式,把模型跑在无 GPU 的设备上。
7.2 训练框架
- Megatron-LM:NVIDIA 的大模型训练框架,3D 并行的标准实现。
- DeepSpeed:微软,ZeRO 全家桶 + 各种优化,训大模型的常用底座。
- ColossalAI:轻量、易用,支持各种并行和混合精度,适合中小团队。
- PyTorch FSDP:PyTorch 原生全分片数据并行,ZeRO 思路的官方实现,无额外依赖。
7.3 压缩工具
- AutoGPTQ:GPTQ 量化的易用封装,几行代码把模型压到 4-bit。
- AutoAWQ:AWQ 量化的封装,保精度地压 4-bit。
- llm-compressor:统一入口做量化/剪枝,支持多种后端。
八、效果评估
加速最终要靠指标说话,否则"快了"只是感觉。两大维度。
8.1 效率指标
- TTFT 首字延迟:从发请求到吐出第一个 token 的时间,决定"响应快不快"的体感。 prefill 越长 TTFT 越高,Prefix Caching、Chunked Prefill 主要降它。
- TPOT 每字延迟:每个后续 token 的平均生成时间,决定"打字快不快"。decode 阶段受 KV Cache、HBM 带宽、投机解码影响。
- 吞吐 Throughput / TPS:单位时间总生成 token 数,衡量系统整体产能。Continuous Batching 主要提它。
- 显存占用:模型+KV Cache+激活共占多少显存,决定单机能塞多大模型/多长上下文。
- 成本 / Token:每个 token 的算力/电费成本,是商业落地的最终指标。
8.2 质量权衡
- 精度 vs 速度:所有压缩/稀疏/低精度手段都在精度和速度之间取舍,量化到 INT4 提速 但可能掉点,要量化"掉了多少、还能不能接受"。
- 压缩后精度损失:量化、剪枝、蒸馏后模型在原基准上掉了多少,是压缩方案能否上线的 红线。
- 基准测试(MMLU 等):用 MMLU、HumanEval、GSM8K 等标准基准量化精度变化,是 "压完还能不能用"的客观依据。
全书小结
八个板块构成一条完整链路:训练加速让模型训得出来,架构优化从源头省算力,模型 压缩让模型变小变快,推理加速把引擎算力榨干,长上下文加速突破长度上限,系统与 硬件提供底层支撑,框架与工具把一切工程化,效果评估用指标把关。理解这张全景图, 再落到具体技术,就是大模型加速优化的全部方法论。